用本地大模型从电影成片反推机位:shotmap 两天折腾实录
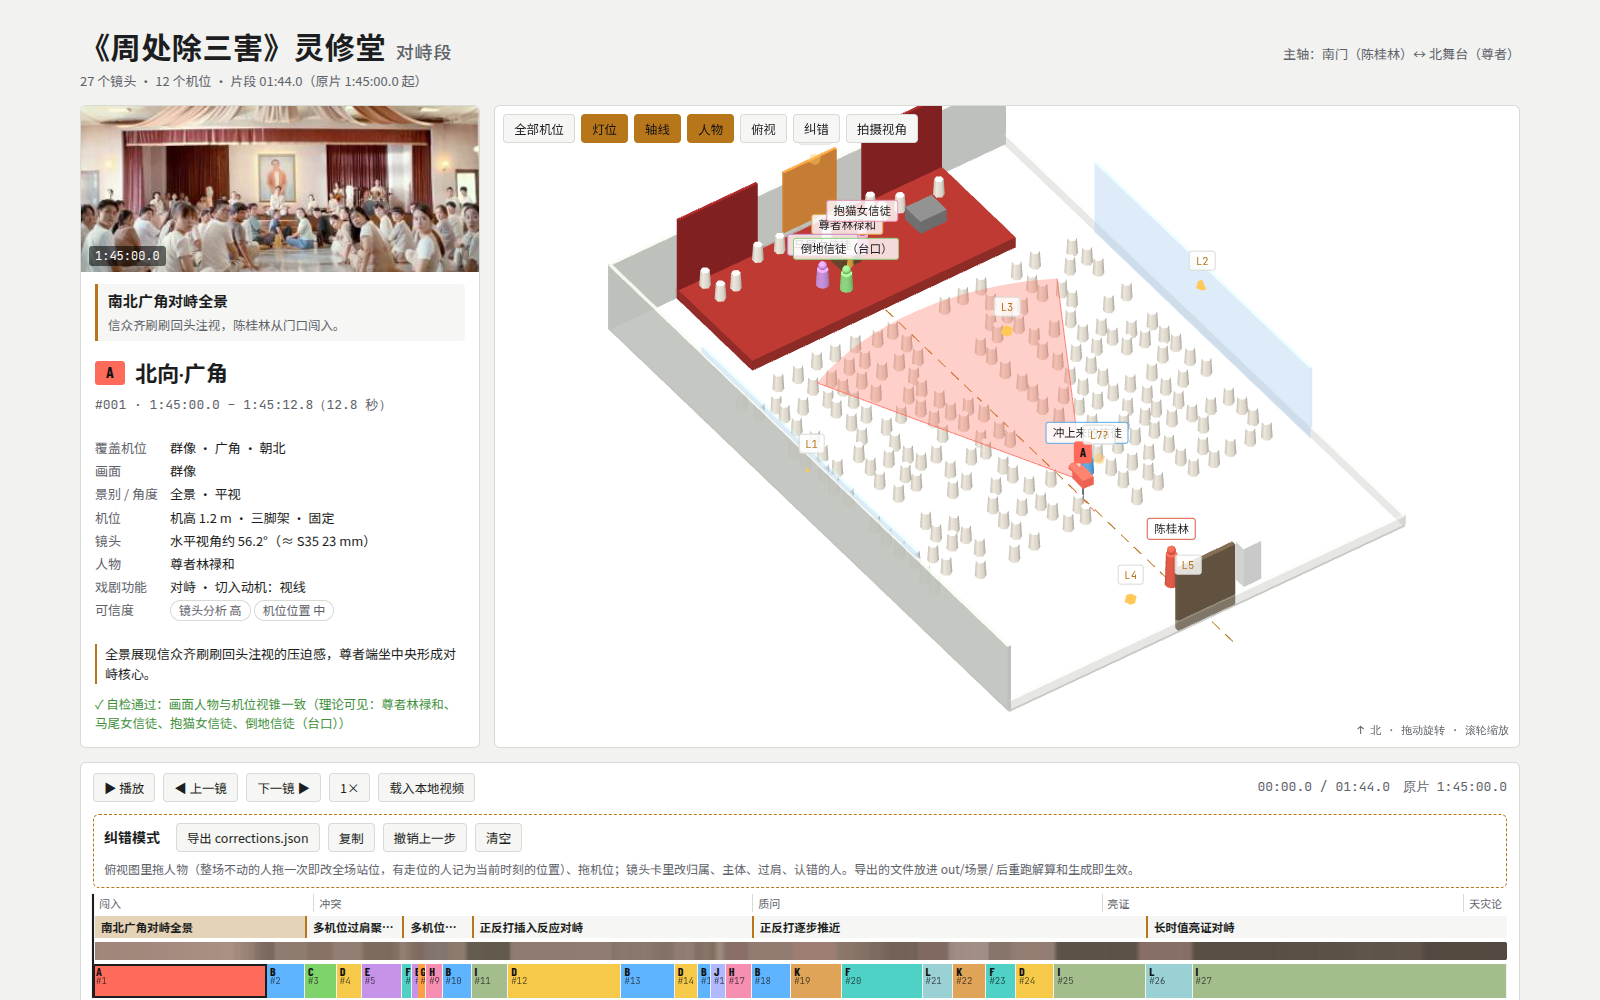
前两天刷到一条小红书视频:把《周处除三害》灵修堂那场戏按镜头切开,每个镜头标出机位、焦段、机高,再画进一张 3D 场景图里,和时间轴同步播放。两千多赞,收藏数几乎和点赞一样多,评论区一片”开源吗”。
我把录屏拆开看了一遍,判断它不是生成视频,而是一套 AI 拉片 + 机位反推的可视化流水线,组件全是现成的。于是决定自己做一个,叫 shotmap,全部跑在家里那台 96GB 显存的工作站上,用本地模型,不调云端 API。
两天、十几个版本之后,它能把一场戏自动拆成镜头、认出人物、推出机位,并生成一个可交互的查看器。这篇记录怎么做的,以及踩过的坑。
最终的流水线
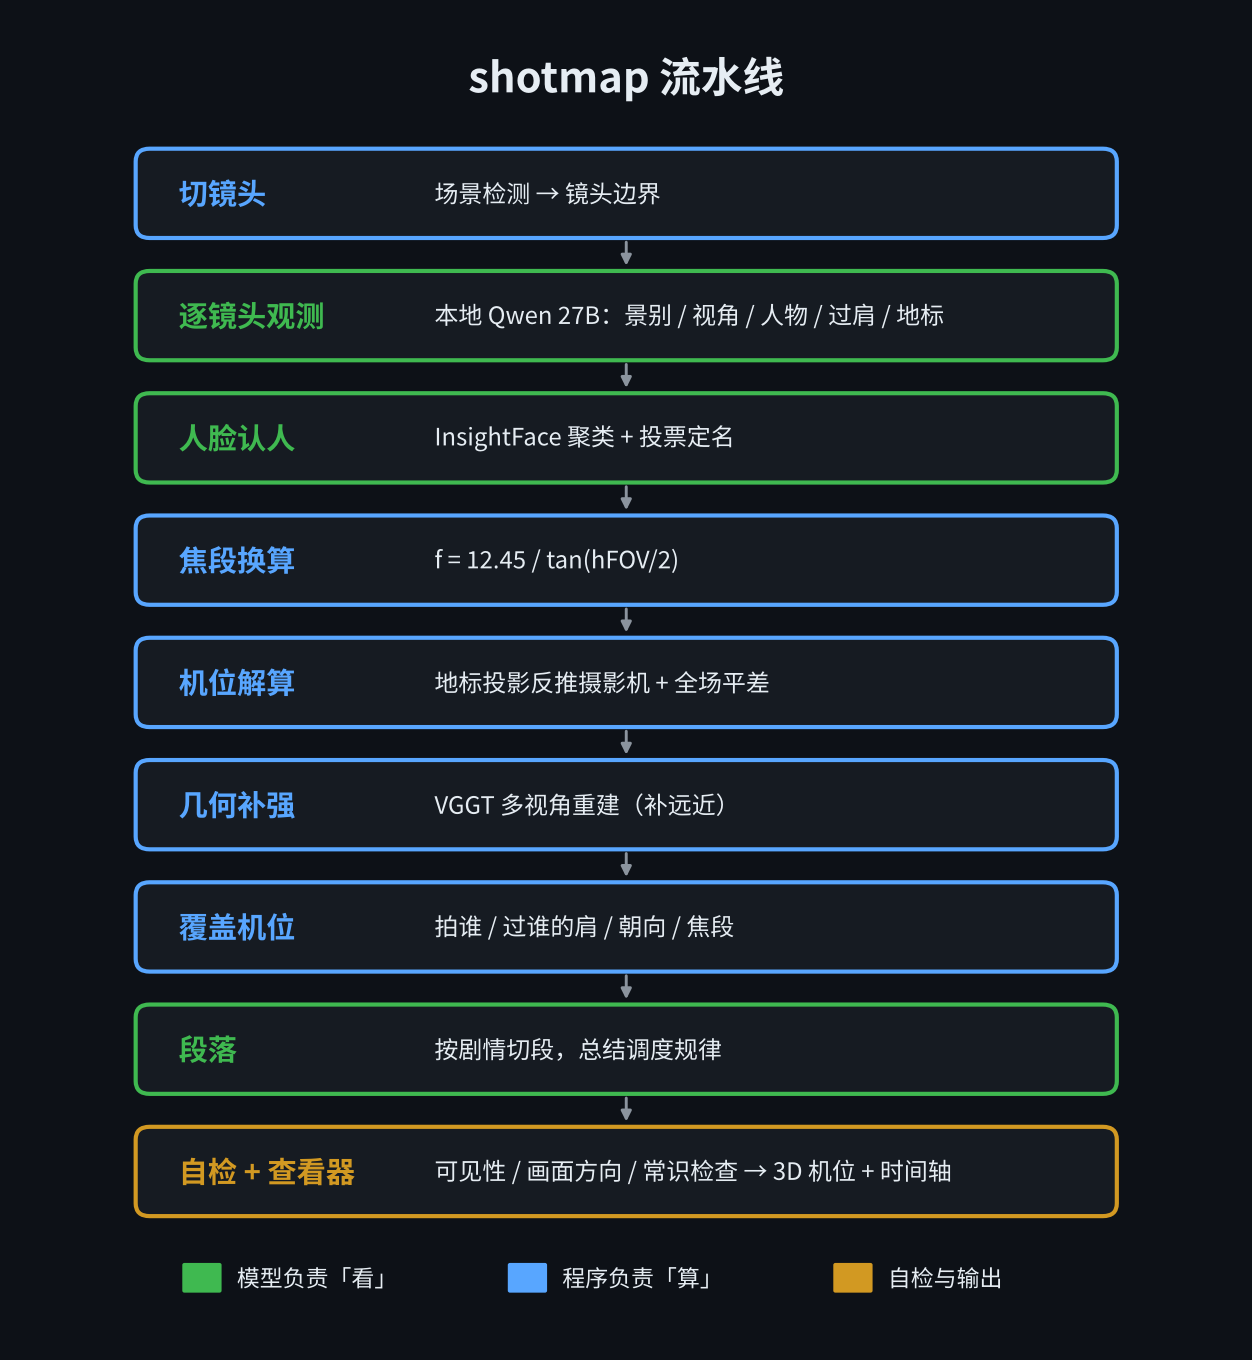
| 步骤 | 做什么 | 用什么 |
|---|---|---|
| 切镜头 | 找出镜头边界和时间码 | 场景检测 |
| 逐镜头观测 | 景别、水平视角、画面里有谁、谁在前景(过肩)、朝向、能看到哪些地标 | 本地 Qwen 27B 视觉模型 |
| 焦段换算 | 由视角推 S35 等效焦距:f = 12.45 / tan(hFOV / 2) | 公式,不让模型猜 |
| 人脸认人 | 检测人脸、按长相聚类,每类按模型的叫法投票定名 | InsightFace + ArcFace |
| 机位解算 | 用平面图地标 + 每个镜头的观测反推摄影机位置,再整体平差 | 自己写的优化 |
| 几何补强 | 多视角重建,补”远近”信息 | VGGT |
| 覆盖机位 | 按剧组的说法归类:拍谁、过谁的肩、朝哪边、什么焦段 | 规则 |
| 段落 | 按剧情切段,总结每段的调度规律 | 本地模型 + 程序算好的事实 |
| 查看器 | 3D 机位、时间轴、镜头卡、拍摄视角 / 剪辑视角切换 | 单个 HTML |
拿来测试的是两场戏:《周处除三害》的灵修堂(27 个镜头)和《寒战》里的一场对峙(76 个镜头)。
坑 1:别让模型做全局空间推理
第一版图省事,把所有镜头的描述丢给本地 27B 模型,让它直接给出整场的机位布局。
结果:13 个机位里有 9 个精确地落在两个主角的连线上,偏离轴线 0.00 米。模型根本没在推理空间,只是把机位都放到了最”安全”的中线上。自检把将近一半的镜头标成了红色。
后来改成分工:模型只负责”看”,每个镜头里框出哪些地标、哪些人、谁在前景;空间交给几何去”算”,用地标的投影位置反推摄影机,再全场一起平差。
改完之后,机位朝向几乎全对,镜头也大致分到了正确的机位上。
坑 2:单张画面判断不了远近
朝向对了,远近还是不准。拍尊者那个机位,解出来离真值差了 9 米。
这不是模型的问题,是物理极限:一张画面里,“长焦站远拍”和”标准焦段站近拍”能拍出几乎一样的画面。查看器里我用虚线标出每个机位可能的前后范围,不假装知道。
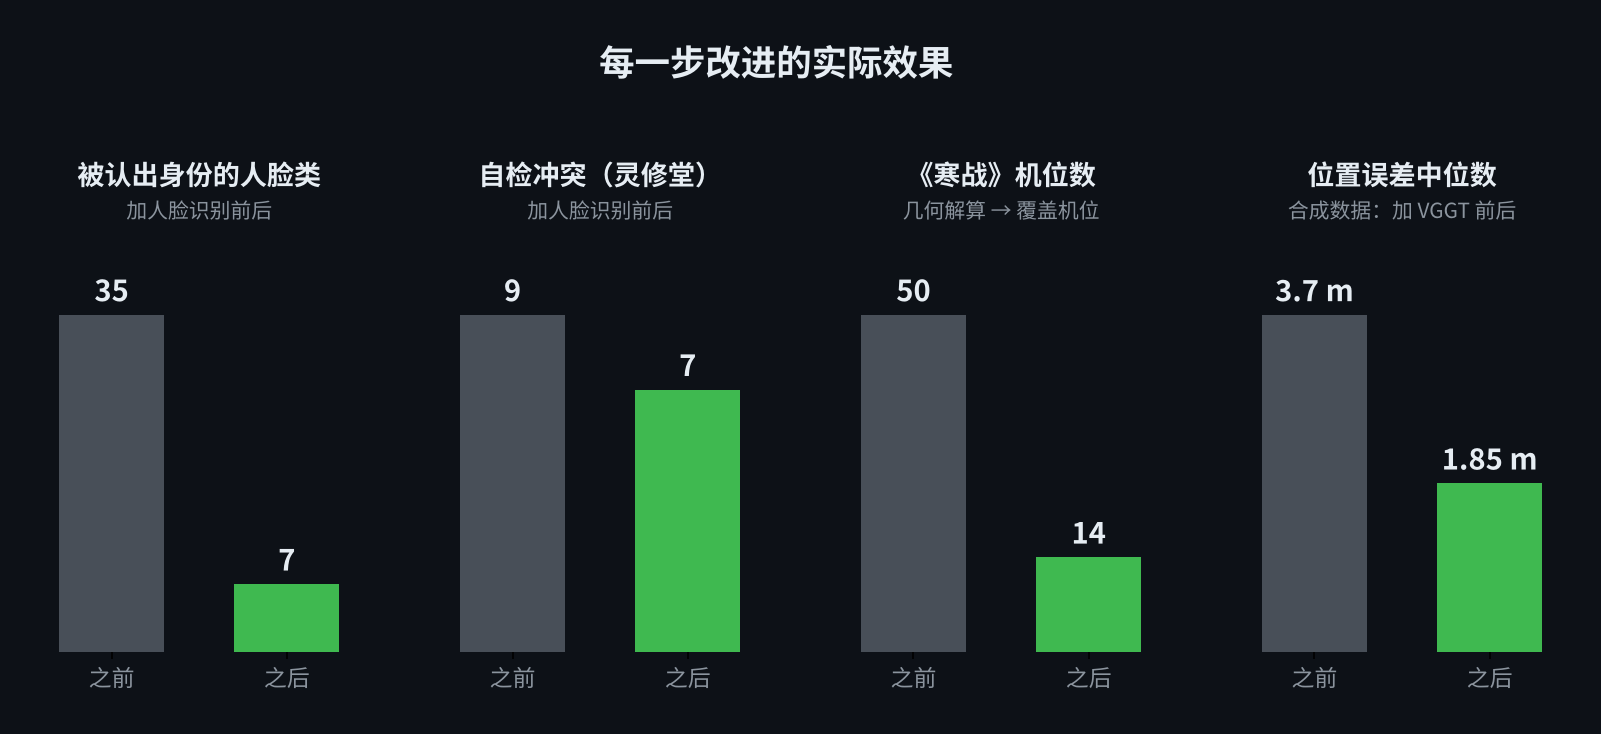
想真正解决,就要有视差信息,所以接入了 VGGT(多视角三维重建)。在合成数据上效果明显:位置误差中位数从 3.7 米降到 1.85 米。推理也快,84 张图 2 秒左右,显存峰值 9.4GB。
但放到真实电影上翻车了:所有机位塌缩到场地正中央。原因是这场戏几乎所有机位都沿着南北主轴拍,我用来对齐的约束只能管住横向,管不住纵向,算法就退化了。对齐检查显示”横向偏差 0.48 米、合格”,其实是假象。
好在自检又拦住了:26 处冲突报警,这次融合结果没有被采用。这条路还在调。
坑 3:认人不能全信模型
模型经常把人认错,比如把陈桂林叫成尊者,把群众演员叫成主角。
加入人脸识别以后,有了明显改善:
- 被认出身份的人脸类从 35 个降到 7 个,群众不再被安上名字;
- 陈桂林那一类正好覆盖了 9 个能看到他正脸的镜头,不多不少;
- 自检冲突从 9 处降到 7 处。
但又冒出一个新问题:有一类人脸出现在朝南拍的镜头里,被投票定成了”尊者”。可那些镜头里尊者在摄影机身后,根本不可能入画。其实那是个光头信徒,只是在几个镜头里恰好被模型叫成了尊者,票数够了。
修法:同一个名字可以对应多个人脸类,但这些类的长相特征必须足够接近。以票数最多的那一类为基准,和它差得太远的类就撤销命名。
坑 4:76 个镜头,50 个机位?
《寒战》那场戏全流程跑了约 19 分钟。人脸认得很好:李文彬 110 张、刘杰辉 75 张、Phoenix 86 张。
但机位解出来 50 个。
一场戏不可能用 50 台机器。近景对话戏里,画面里往往只有一两个人、几乎没有地标,每个镜头的位置都解不准,散了一地。
我换了个思路:用剧组的单位,而不是 3D 坐标。导演排拍摄计划时不会说”机位在 (8.6, 3.0)“,而会说”拍李文彬,过刘杰辉的肩,长焦”。这几样信息在近景里恰恰都看得清。
于是新增了”覆盖机位”:先按”拍谁 / 过谁的肩 / 朝向 / 焦段”给镜头归类,再由覆盖机位推出物理机位:
- 过肩镜头:机器放在”主体 → 前景人物”连线的延长线上;
- 同一主体的标准和长焦:合并成一个机位,标注”换焦段,或 A/B 两台并排”。
几何解算明显过碎时,程序自动切换到这种模式。《寒战》因此从 50 个机位收拢到 14 个,就是一场标准的对话戏覆盖。
自检比准确率重要
回头看,每一次翻车都不是我自己发现的,而是自检发现的:
- 可见性检查:按解出的机位和人物站位,判断这个人应不应该出现在画面里。《寒战》里它报了 13 处错,帮我找出了自己画的平面图里两个人站反了。
- 画面方向检查:统计每个人物在画面里看向哪边。它还意外发现了一个真实的调度手法:约 190 秒处人群涌动,摄影换到了轴线另一侧,重新建立了轴线。
- 常识检查:一场戏 50 个机位,这种结果直接判为不可信。
不会出错的系统不存在。能把自己的错报出来的系统,才能迭代下去。
它现在能告诉我什么
两场戏放在一起对比,第一次能用数字说清楚它们的拍法差别:
- 开场方式不同:灵修堂用正反两个方向的全景交代空间,平均每镜 7.8 秒;《寒战》用一个 22.7 秒的跟拍长镜头,边走边交代。
- 对话主力不同:《寒战》以长焦过肩为主(视角约 17°,最大的一组覆盖 18 个镜头);灵修堂以广角、标准焦段的过肩全景为主。
- 共同点:冲突升级时都逐步推近景别,平均每镜 3~3.5 秒。
段落总结我也给模型立了规矩:每条规律必须写成”当〔条件〕时,用〔做法 + 参数〕,让观众〔效果〕“,参数来自程序算好的事实;“张力""氛围""压迫感”这类空词不许单独出现。
下一步
每分析一场戏,就把它的段落规律存进方法论库。攒够四五部片之后,按条件归类,就是一套能直接拿来用的调度模板。
我做 AIGC 短片时最缺的就是这个:知道”这种戏该怎么拍”,而不是每个镜头靠感觉写提示词。shotmap 已经能为每个镜头输出一份”生成规格”,接下来要做的就是把这两头接起来。
小结
- 本地 27B 模型适合当眼睛,不适合当大脑做全局空间推理;
- 物理上推不出来的东西(单画面的远近),就老实标出不确定范围;
- 用行业自己的单位(覆盖机位)描述结果,比追求精确 3D 坐标有用得多;
- 自检是整个系统里最值钱的部分。