等一台 512GB 的 M5 Ultra Mac Studio:不图快,只图装得下
先说结论:512GB 版的 M5 Ultra Mac Studio 我大概率会买。 不是因为它快,而是因为它装得下。
我现在卡在哪
家里的主力机是一块 RTX PRO 6000,96GB 显存。这块卡同时干两件事:
- 跑本地大模型:常驻一个 27B 的模型,做内容流水线和 agent,模型加上下文就吃掉三四十 GB;
- 跑视频生成:本地视频模型一开,又要几十 GB。
两件事抢同一块卡,结果就是排队、调度,夜里还得暂停大模型给视频让路。
更难受的是另一头:96GB 装不下真正的大模型。 两三百 B 往上的 MoE 模型,哪怕量化到 4 bit,权重加上下文也远超 96GB。本地能跑的天花板,就卡在 30B 这一档。
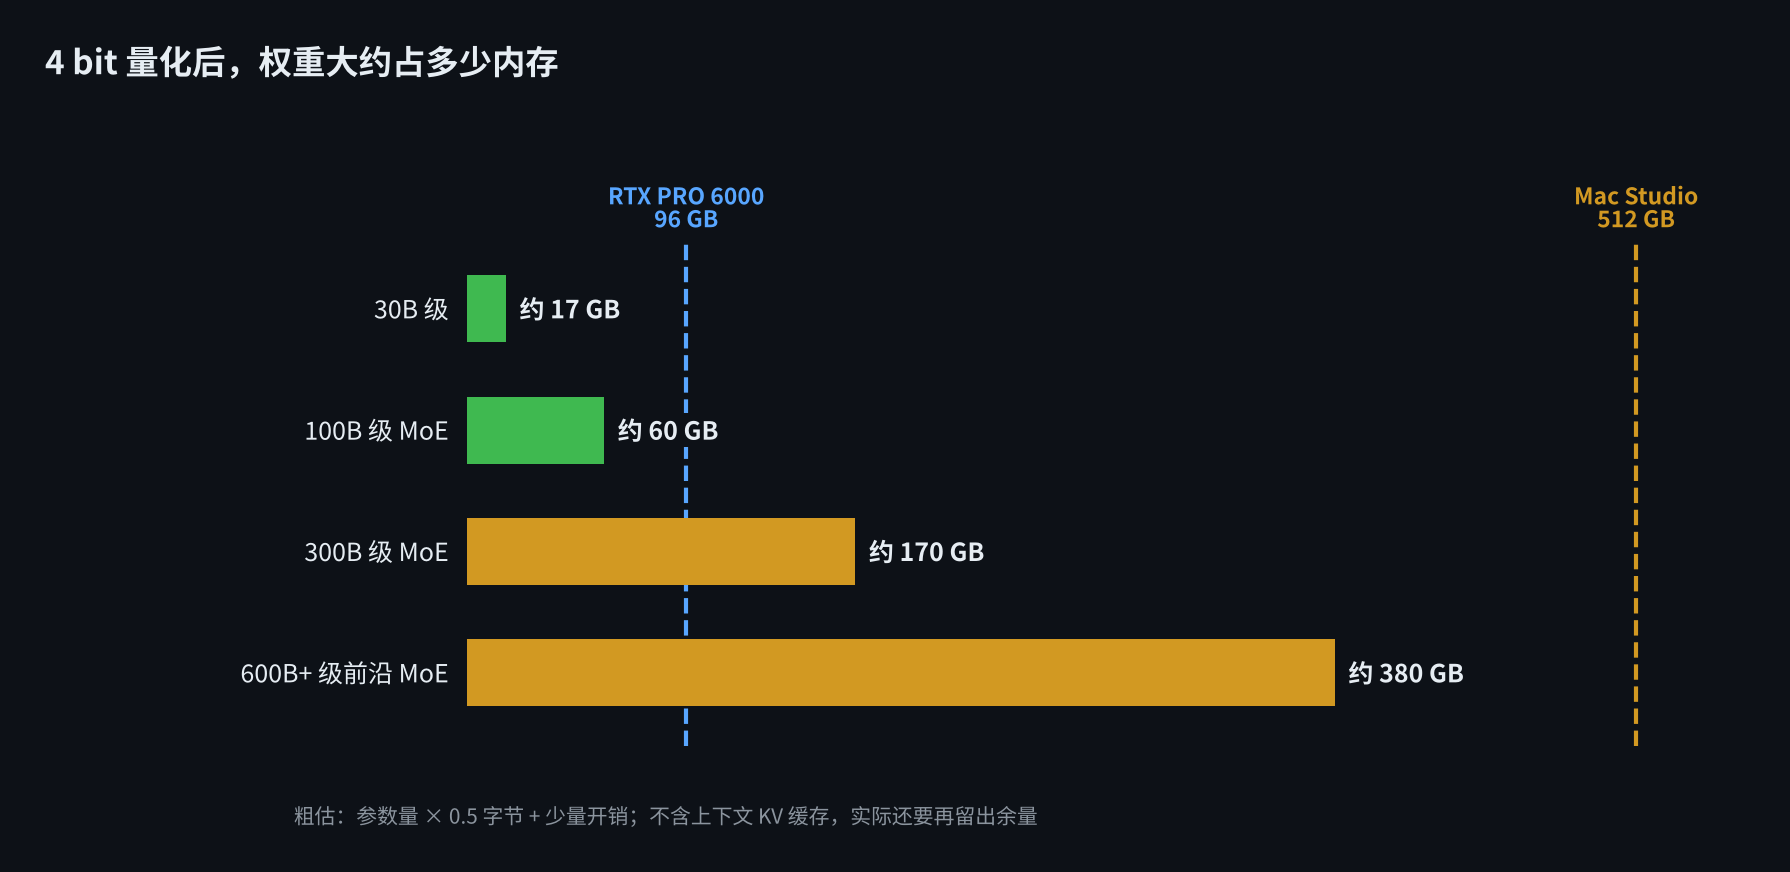
所以我对新机器的要求非常单纯:突破 96GB 这道门槛。
M5 Ultra 给了什么
8 月底苹果发布了 M5 Max 和 M5 Ultra 两款 Mac Studio。和我有关的就几条:
- 统一内存最高 512GB,带宽最高 1.2TB/s;
- GPU 每个核心里都带了神经网络加速器,这是 Ultra 芯片第一次有;
- 苹果官方说,在 LM Studio 里处理提示词比 M3 Ultra 快约 4 倍;
- 512GB 版要到 10 月下旬才开卖。
价格就不提了,反正不便宜。但这个容量档位,也没有别的选择:用 NVIDIA 的卡凑出 300GB 以上的显存,钱、功耗、机箱和散热,哪一样我都扛不住。
计划拿它做什么
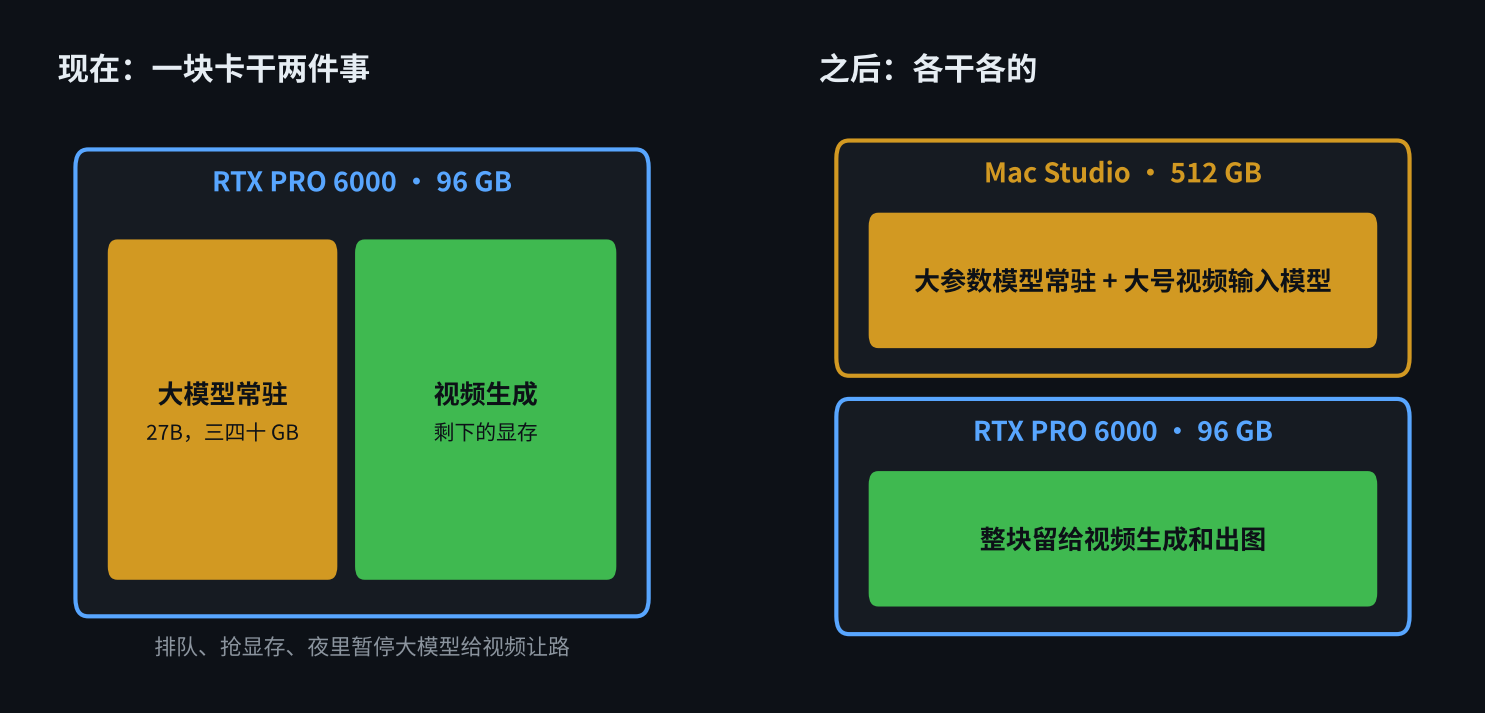
1. 把 PRO 6000 整块腾给视频。
大模型搬到 Mac 上常驻,PRO 6000 就不再被它占着,96GB 整块留给视频生成和出图,不用再排队、抢显存。这个间接收益,可能比 Mac 本身还大。
2. 体验本地的前沿大模型。
像 DeepSeek V4.1 Flash 这一档的前沿开源模型,96GB 根本装不下,只能调 API。我一直更信任本地部署,自己的机器、自己的模型,内容生产才能稳定持续地跑下去。512GB 终于能把这类模型请回家。
3. 给 shotmap 换更大的”眼睛”。
最近在做 shotmap,从电影成片反推机位。现在逐镜头看画面的是一个 27B 的视觉模型,它一个镜头一个镜头地看,全局空间推理基本做不了。我很想试试更大的、能直接吃视频输入的多模态模型:让它一次看完一整场戏,效果会不会有质的变化。这在 96GB 上没法试。
我不对速度抱任何希望
这一点要先说清楚,免得将来自己失望。
我手上有一台 M5 的 MacBook Pro,用它跑过 Qwen3.6 27B,也试过用 oMLX 加速。提升感知很明显,但和 NVIDIA 的卡比,仍然是巨大的差距。
道理也简单:
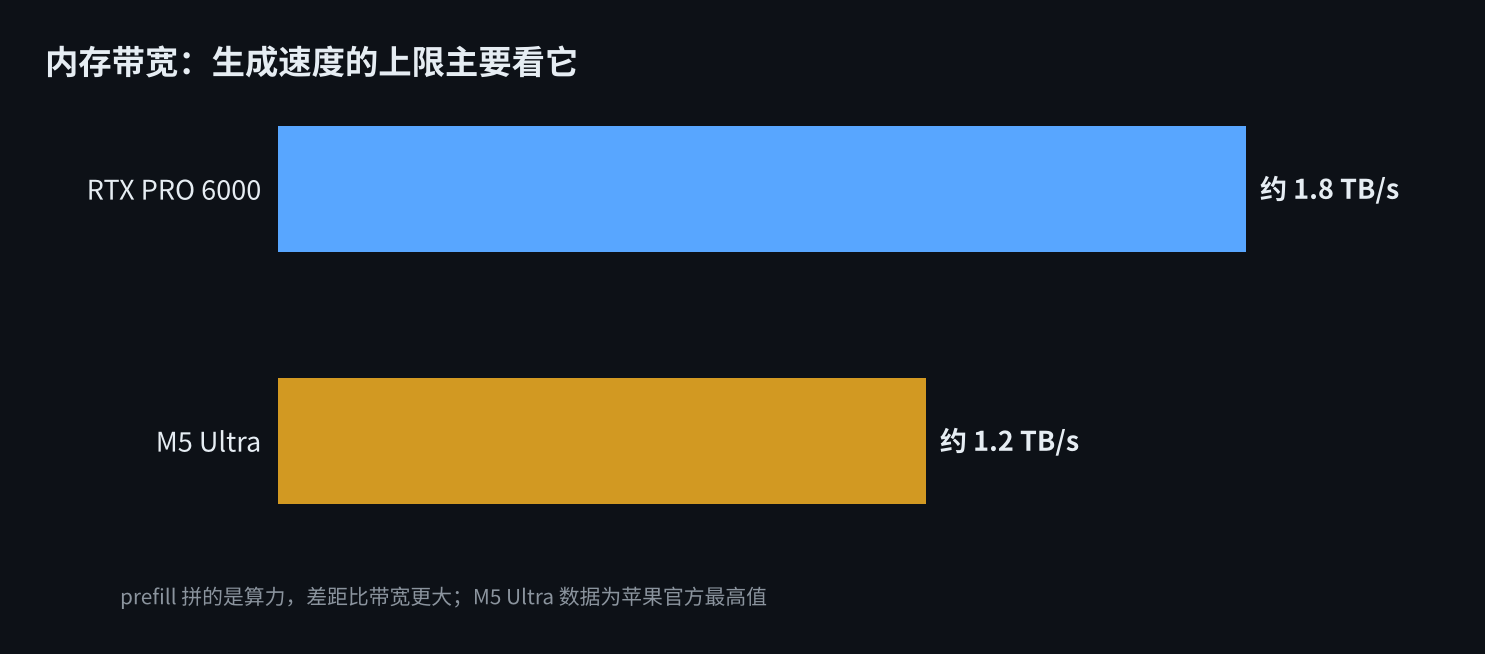
- 生成速度主要看内存带宽。M5 Ultra 是 1.2TB/s,PRO 6000 约 1.8TB/s,Mac 先天就慢一截。好在 MoE 模型每个 token 只激活一小部分参数,生成速度还能接受,但不会惊艳。
- **prefill(读提示词)**拼的是算力,这是苹果的老短板。这次加了 GPU 神经加速器、官方说快了 4 倍,但我在笔记本上的体感告诉我,长上下文开头那段等待大概率省不掉。
所以买 Mac Studio 不是为了”体验苹果的本地 AI”,我已经体验过了。它慢可以接受,装不下才是真问题。
到手之后要验证的几件事
- 前沿 MoE 模型量化后,实际的生成速度和 prefill 速度各是多少;
- 32K、128K 上下文下,首个 token 要等多久;
- 大号的视频输入模型能不能跑起来,看一整场戏的效果如何;
- 能不能 7×24 小时稳定跑长任务,不掉服务;
- PRO 6000 腾出来以后,视频生成的排队时间实际省了多少。
到手后按这几项实测,再写一篇。